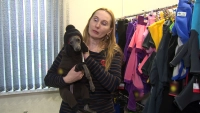
Ассистент института информационных технологий и технологического образования РГПУ имени А.И. Герцена Татьяна Устюгова объяснила, почему языковые модели могут так уверенно ссылаться на несуществующие книги и цитировать выдуманных ученых. Об этом 17 ноября рассказали в пресс-службе университета.
Эксперт отметила, что алгоритм не пытается обмануть пользователя. Программа просто подбирает наиболее вероятное продолжение фразы, заполняя пробелы в знаниях логичными, но искусственными связками. Для модели важно создать связный текст, а не проверить его достоверность. Поэтому вымышленные фамилии и статьи звучат абсолютно убедительно.
Чтобы не попасть впросак, эксперт советует проверять факты, от которых зависит главный вывод. Все цифры, даты и ссылки нужно искать в первоисточниках, а неподтвержденные данные лучше убрать.
Также важно правильно ставить задачу. Абстрактный запрос вроде «Расскажи все о Петре I» не задает нужный формат, и модель может выдать бесполезный общий ответ.
Отдельный вопрос – ответственность самого пользователя. Особенно это касается студентов – кто виноват, если учащийся сдаст работу с ИИ-фактами? Ответ прост – нейросеть может ошибиться, но именно студент решает, использовать ли ее текст. Эксперт напомнила, что правила университетов различаются, поэтому нужно следовать требованиям преподавателя и не выдавать непроверенный текст за свою работу.
«Важно четко разделять несовершенство технологии и ответственность студента за итоговый текст. Грамотный промпт действительно помогает яснее поставить задачу, но он не отменяет фактчекинг и не превращает нейросеть в безошибочную базу знаний», – заключила Татьяна Устюгова.